03 / DOCUMENT QA & SFT
文档问答:从题型数据到 LoRA 微调
通过任务数据、人工审核与受控对照,让模型更好地完成企业文档中的抽取、比较、判断和推理。
业务问题
通用模型面对企业文档中的抽取、比较、判断和推理题,表现不够稳定。
我的工作
构建题型数据,组织模型粗排+人工精排,进行 LoRA 微调与对照评估。
主要结果
71% → 78%内部 FileChat 评估集的文档问答准确率让训练数据覆盖实际文档任务
企业文档问答不仅是从原文抄出一句话。合同、规范和产品资料里,还存在跨段比较、条件判断与多步推理。只有同义改写或简单抽取的数据,难以覆盖这些任务。
我负责数据方案比较、任务数据构造、SFT 训练与效果对照:在 GLM、Baichuan、Llama、Qwen 等模型上比较不同数据方案,将数据整理、人工校验、微调与模型评测连接起来。
从题型生成到人工校验,再到模型对照
按文档与题型构造数据
围绕合同、规范、产品文档生成抽取、比较、判断和推理题,由 GPT-4 按指定题型生成问答,难题加入 CoT。训练 query 与评估 query 分开构造。
模型粗排+人工精排
模型先筛选,再由两位标注人员对照原文检查题型、答案与推理链并纠错,整理约 3K 条合成训练数据,避免错误答案进入训练。
LoRA 训练与错误分类
使用 LLaMA-Factory 对 72B 开源模型进行 LoRA 微调;在 SFT 前后对照中仅替换模型,同时保留多模型横评及错误、无关回答、遗漏等记录。
两张原图:题型覆盖与模型横评
第一张图说明数据覆盖了哪些任务,第二张图保留模型版本、样本数与错误分类。结合两张表,可以讨论数据构造与模型选型各自解决的问题。
实验 1 · 文档合成问答的题型分布
完整实验原图 · 点击放大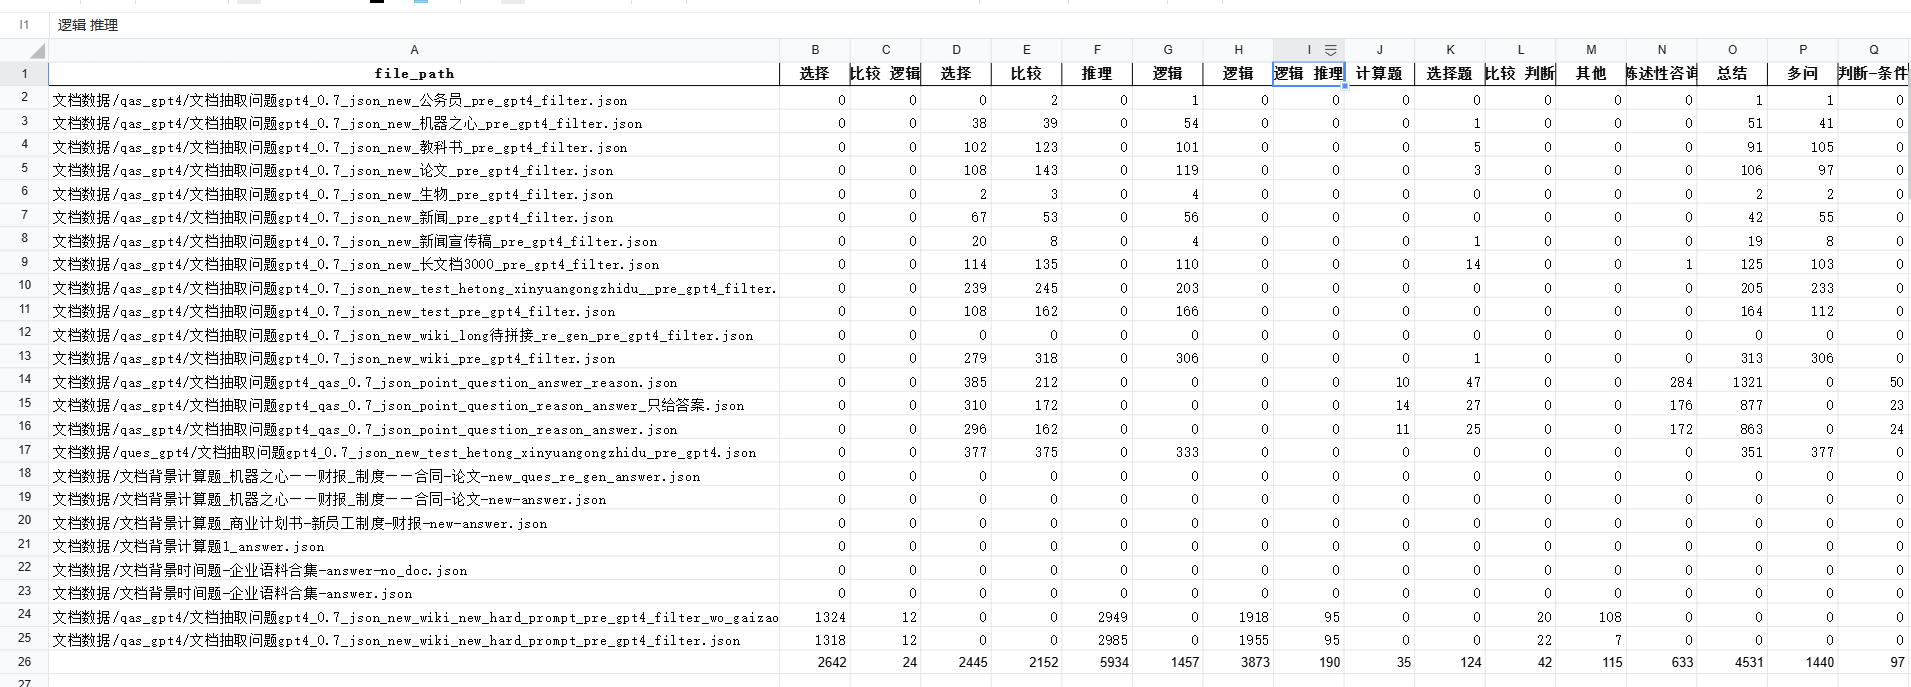
看什么:题型覆盖是否偏向简单任务,以及比较、推理和计算类问题是否获得独立的数据构造与检查。
实验 2 · 文档问答模型与错误类型横评
完整实验原图 · 点击放大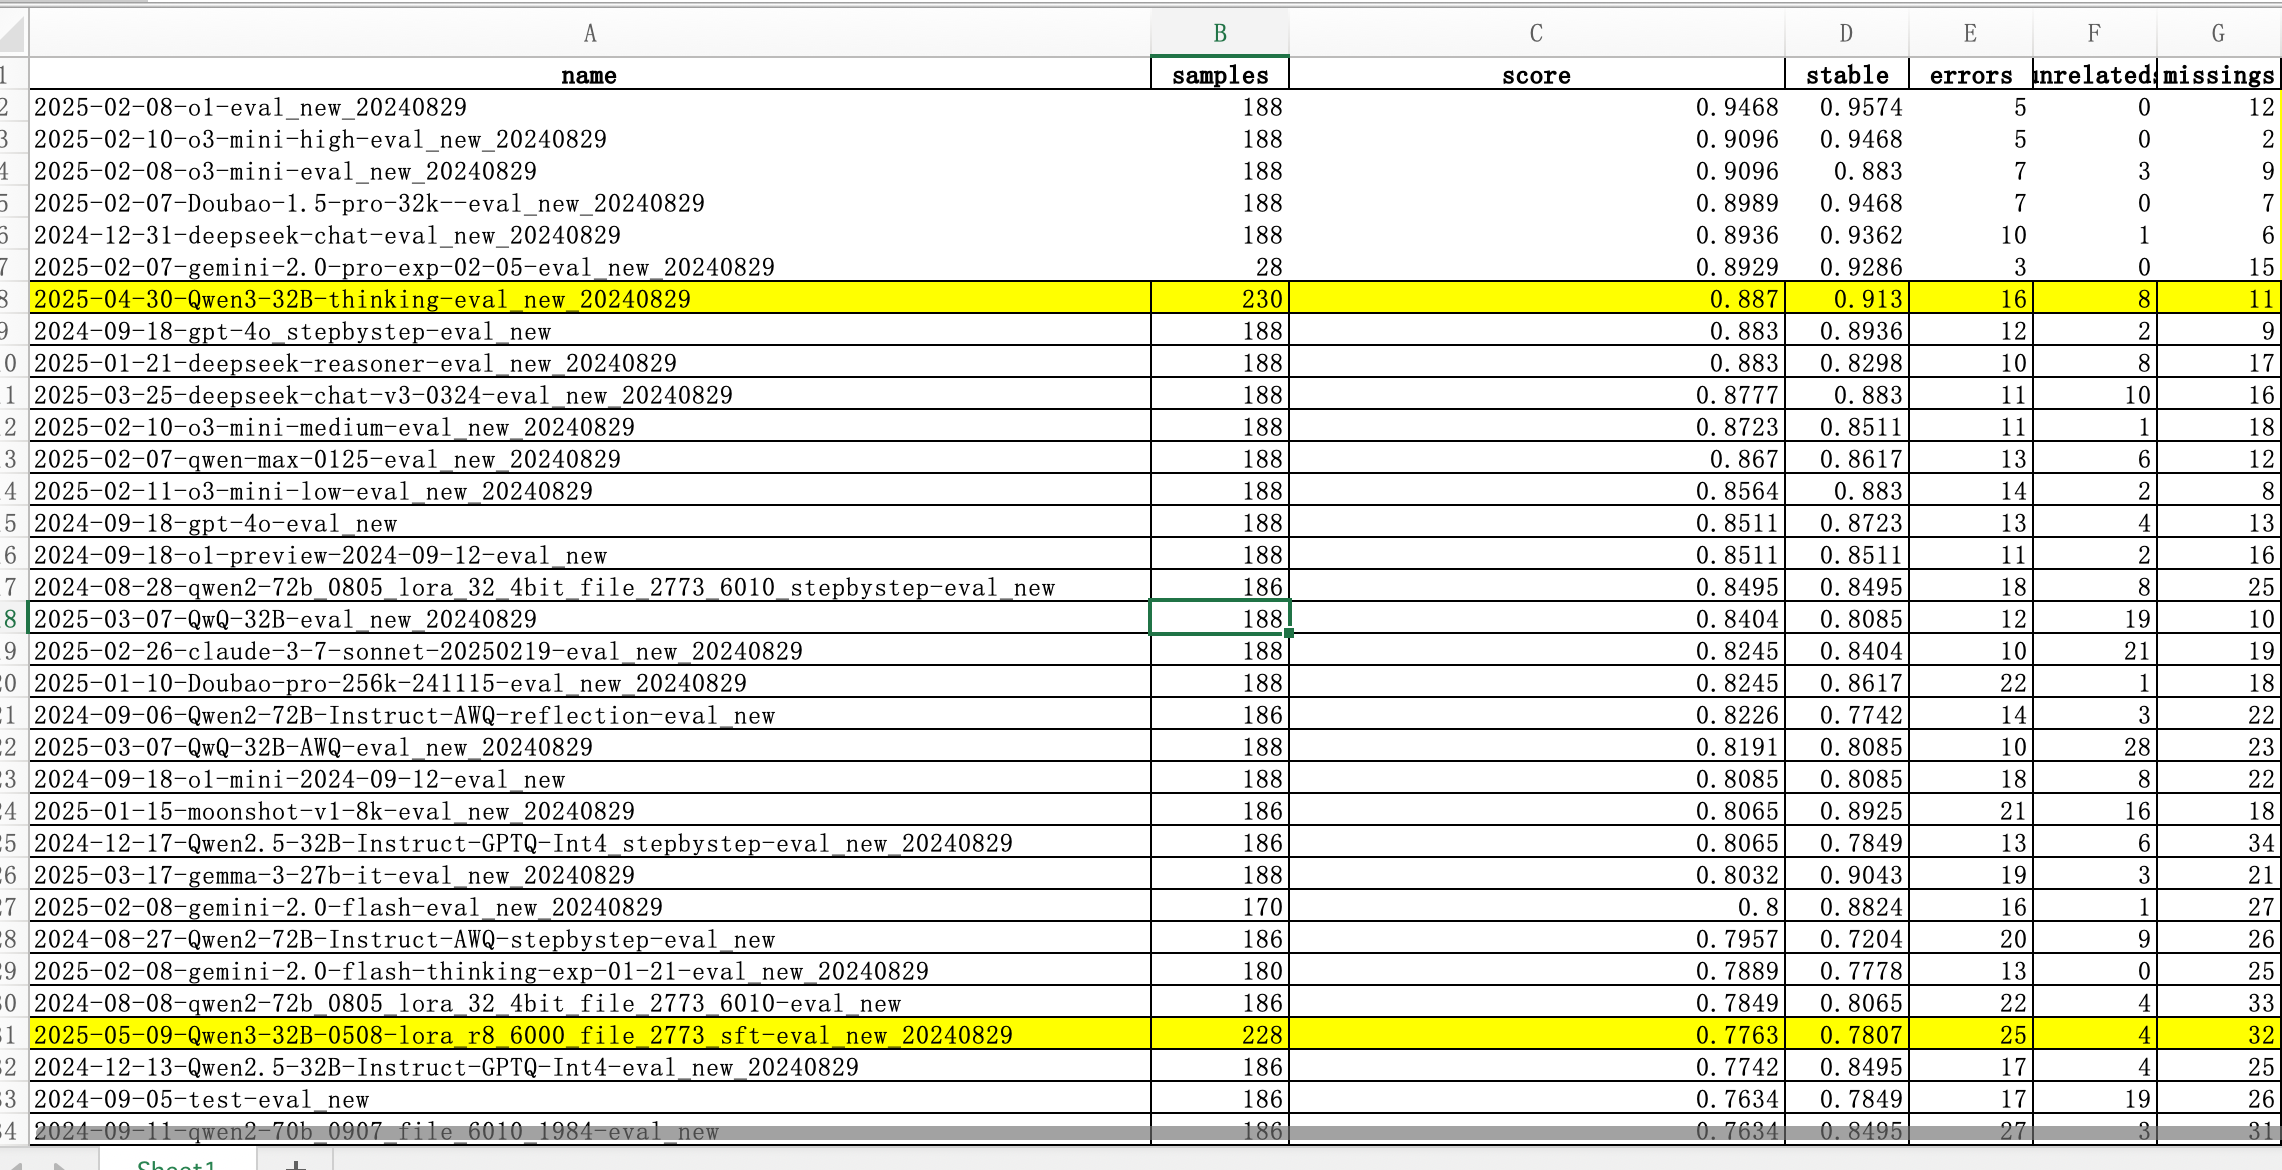
看什么:除总分外,同时检查错误、无关回答与遗漏。表内 28 / 170 / 180 / 186 / 188 / 228 / 230 等样本规模不同;对照应先对齐评估批次,71%→78% 的项目结果按独立的 SFT 前后对照记录。
以固定任务上的提升判断训练价值
约 3K 条数据完成文档问答微调
基于约 3K 条人工审核的合成数据进行 LoRA 微调,内部 FileChat 文档问答准确率从 71% 提升至 78%,微调模型已上线。这里的结果是最终文档问答准确率。
评估口径:FileChat 统计最终文档问答准确率,SFT 前后对照仅替换模型。模型横评表同时保留样本量、错误、无关回答与遗漏;不同评估批次分别比较。