01 / EMBEDDING & SEMANTIC RETRIEVAL
跨行业 Embedding:从逐项目训练到统一底座
将多行业语义数据、模型训练与推理服务串成一条交付链路,兼顾业务意图识别效果、复用能力和服务并发。
业务问题
行业、意图和表达不断增加,逐项目微调分类模型的维护成本高。
我的工作
训练统一 Embedding 底座,构建业务对照与难例分析,完成轻量化和服务优化。
主要结果
73% → 93%中国银行约 2 万意图场景的业务意图识别准确率为什么要做统一语义底座
银行、物流、运营商和政务的知识与意图持续变化。沿用“每个项目训练一个分类模型”的方式,新增意图、迁移行业和修改知识都会反复牵动训练与交付。
我负责将这条链路升级为可复用的语义检索底座:围绕 query 与候选知识的语义匹配建设训练数据和模型,让多行业项目共用语义能力,再通过业务评估检查行业术语、英粤表达、实体与反义场景。
数据、模型与服务一起优化
融合公开与多行业数据
融合千万级 STS 与业务语义数据。比较 SimCSE、ArcCSE 与蒸馏方案,采用 ArcCSE+Triplet Loss 训练可复用底座;后续持续进行不同骨干、checkpoint 与融合方案对照。
建设跨行业业务评估集
基于 5 个行业、10 个业务场景的约 5 万条用户 Query 构造语义匹配文本对,利用 GPT mini 等模型构建评估 label,并经多模型交叉校验。结合否定词、实体误触等难例,比较不同版本与粗排、精排方案。
兼顾交付与推理并发
通过 Tiny 蒸馏、ONNX 与多进程推理优化服务;结合 Redis+Nacos 实现模型热加载及多节点同步,降低模型更新对交付的影响。
数据建设与模型实验记录
以下材料保留了不同阶段的训练与评测记录。每张图分别说明一个决策环节;Jina 微调对照、难例得分与 C-MTEB 子任务各自按原表的模型和数据范围阅读。
数据建设 · 千万级 STS 训练语料
数据来源节选 · 点击放大融合公开语义匹配数据与多行业业务意图数据,基于千万级 STS 数据训练统一 Embedding 底座。下表展示部分数据来源、样本量与业务说明。
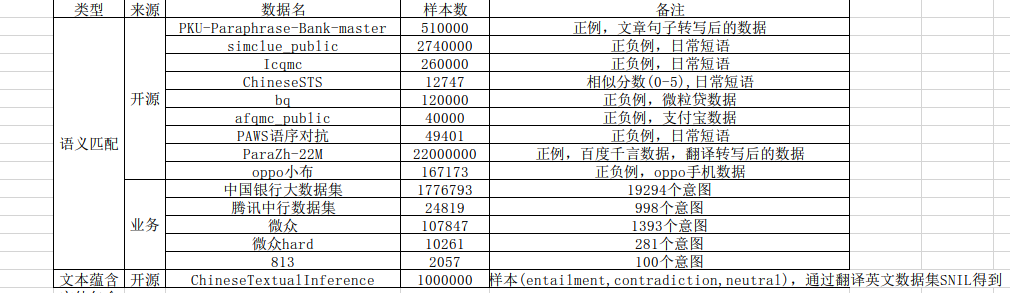
看什么:统一语义底座的数据覆盖,以及公开语义数据与行业意图数据如何共同组成训练来源。
数据建设 · 跨行业评估集与模型对照
业务评估记录节选 · 点击放大5 个行业 · 10 个业务场景 · 约 5 万条用户 Query。围绕用户 Query 构造语义匹配文本对,利用 GPT mini 等模型构建评估 label,并通过多模型交叉校验,用于模型选型与版本迭代。下图为不同业务、评估批次与模型版本的对照记录。
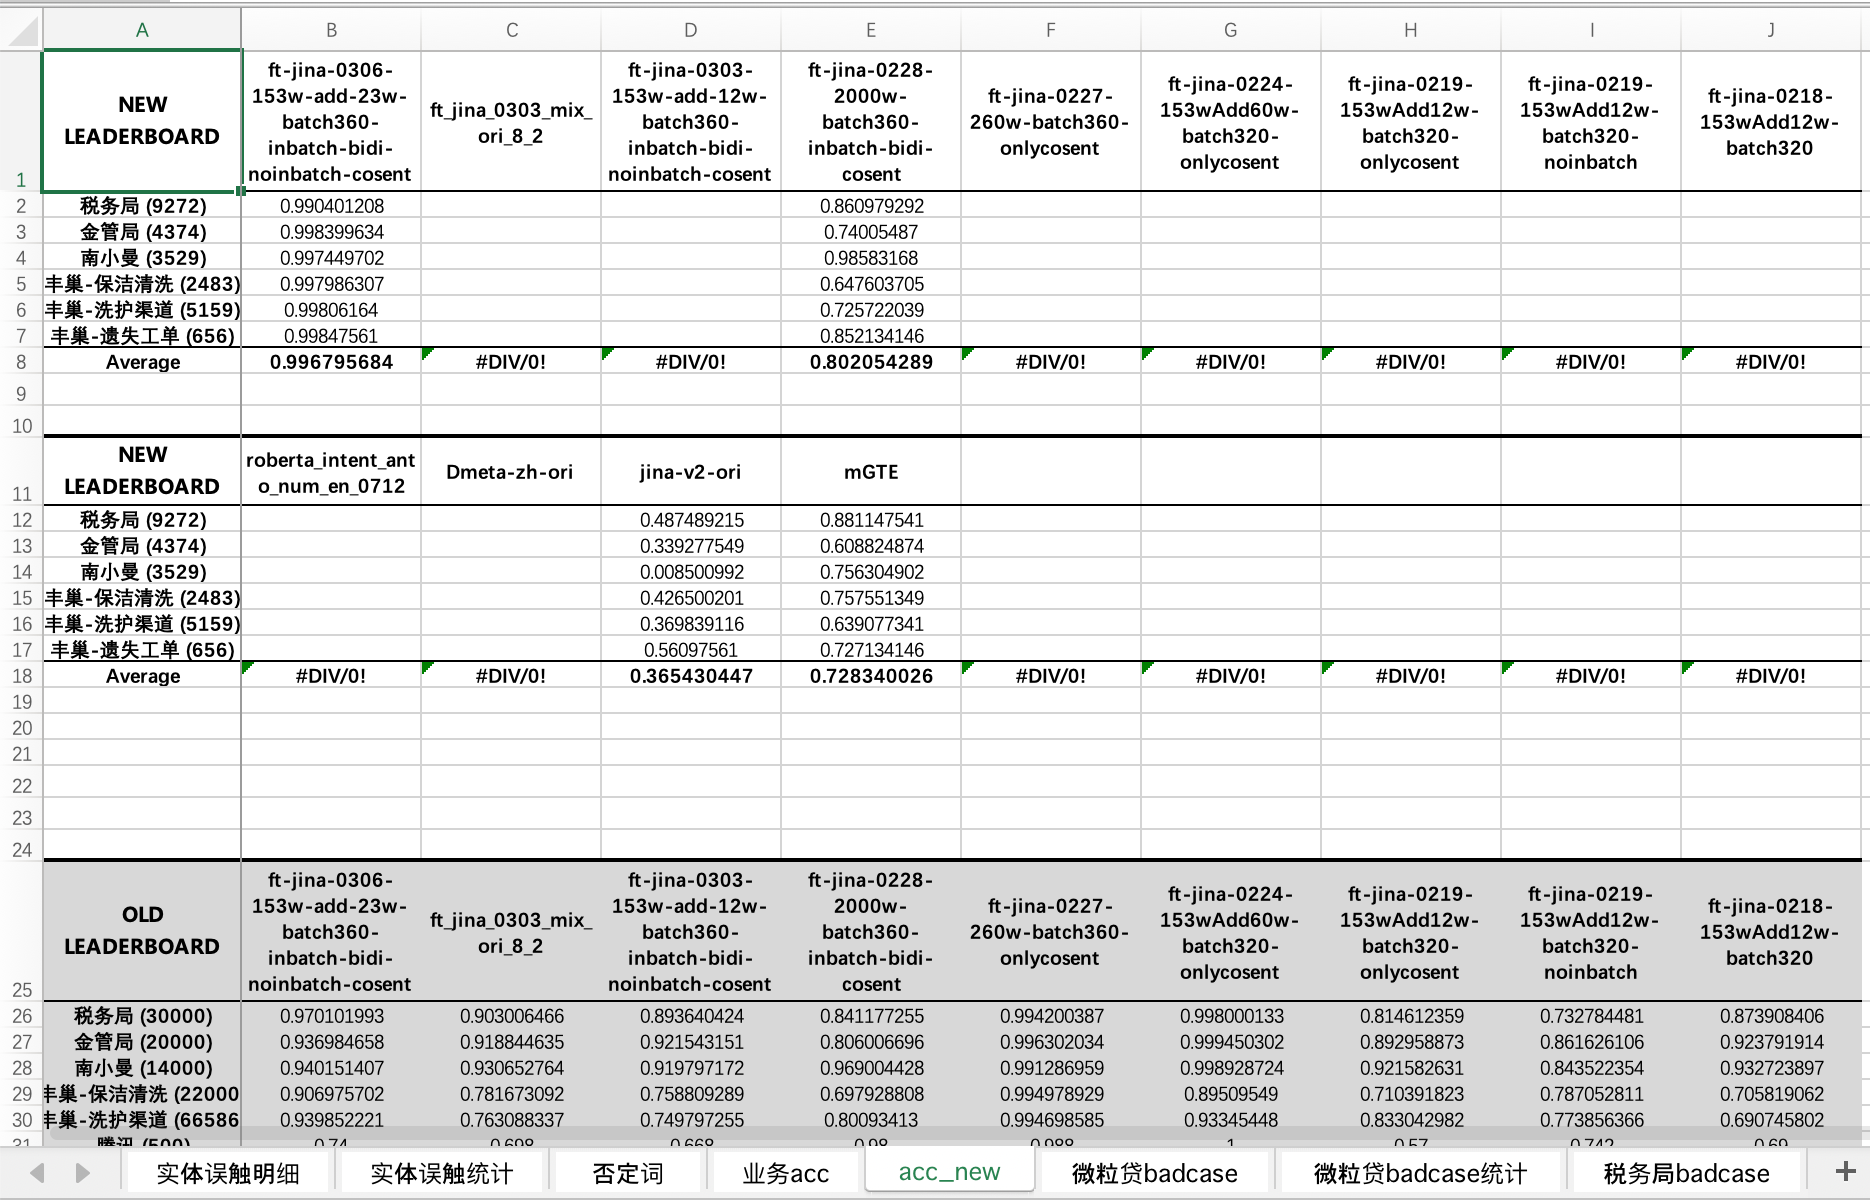
看什么:不同版本在各业务上的变化,以及新旧评估分布的差别。表内平均值仅用于对应评估记录,不替代中国银行 2 万意图项目的准确率。
实验 3 · 粤语 query 的正负候选与粗排+精排得分
完整实验原图 · 点击放大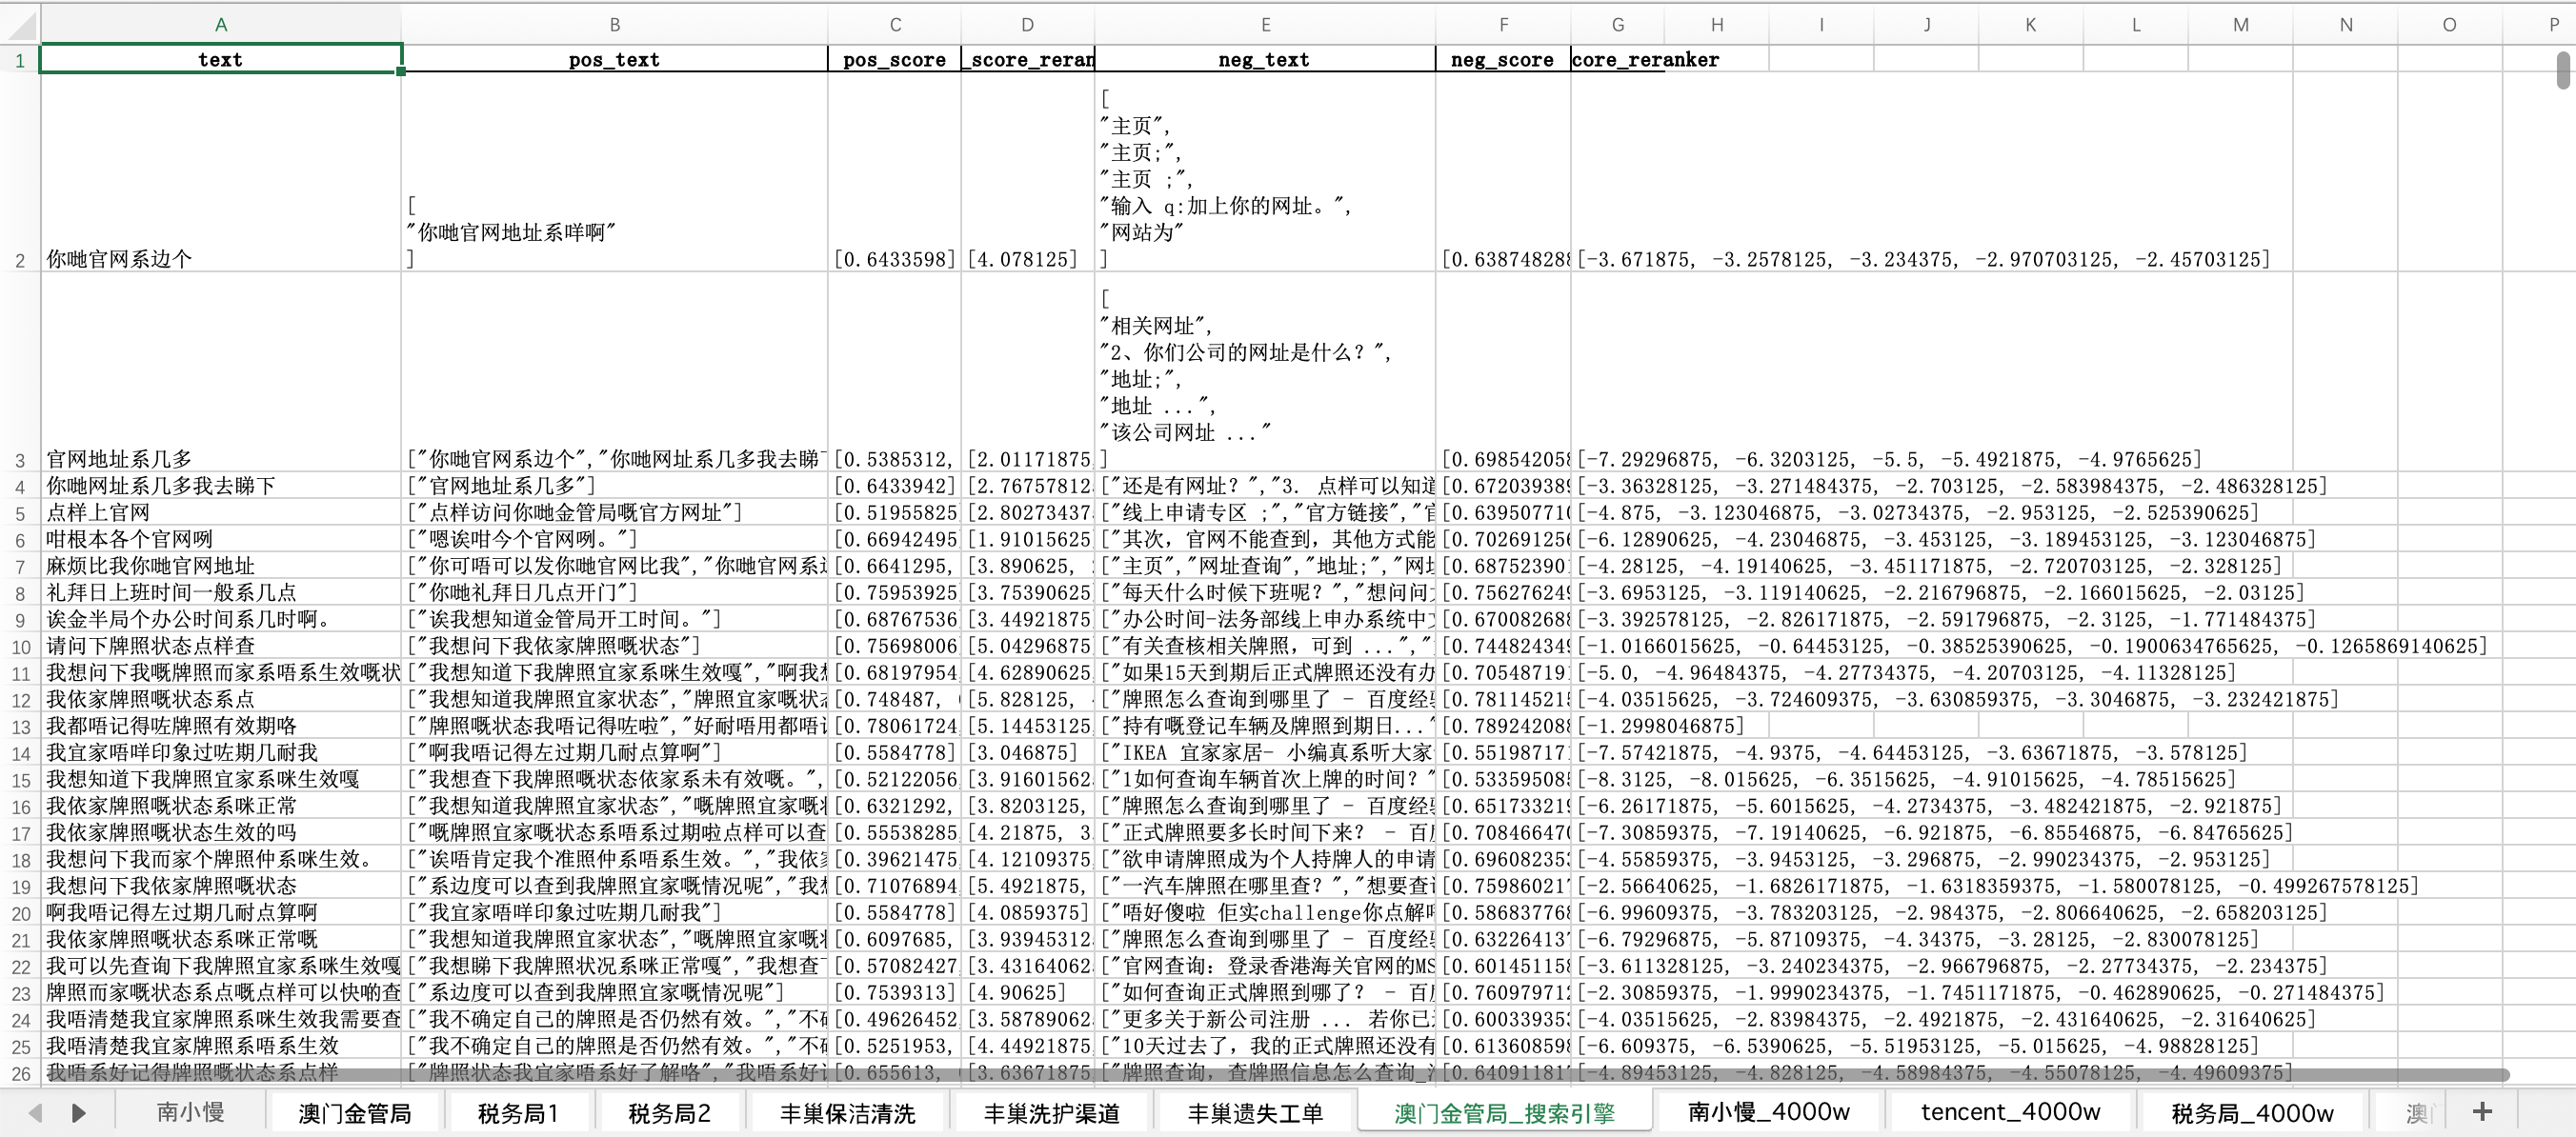
观察:首条记录中,粗排给正样本与负候选的分数很接近,而精排将其拉开。这提供了判断语义边界的具体样本;两类模型的分数标度分别阅读。
实验 4 · C-MTEB 检索子任务对照
完整实验原图 · 点击放大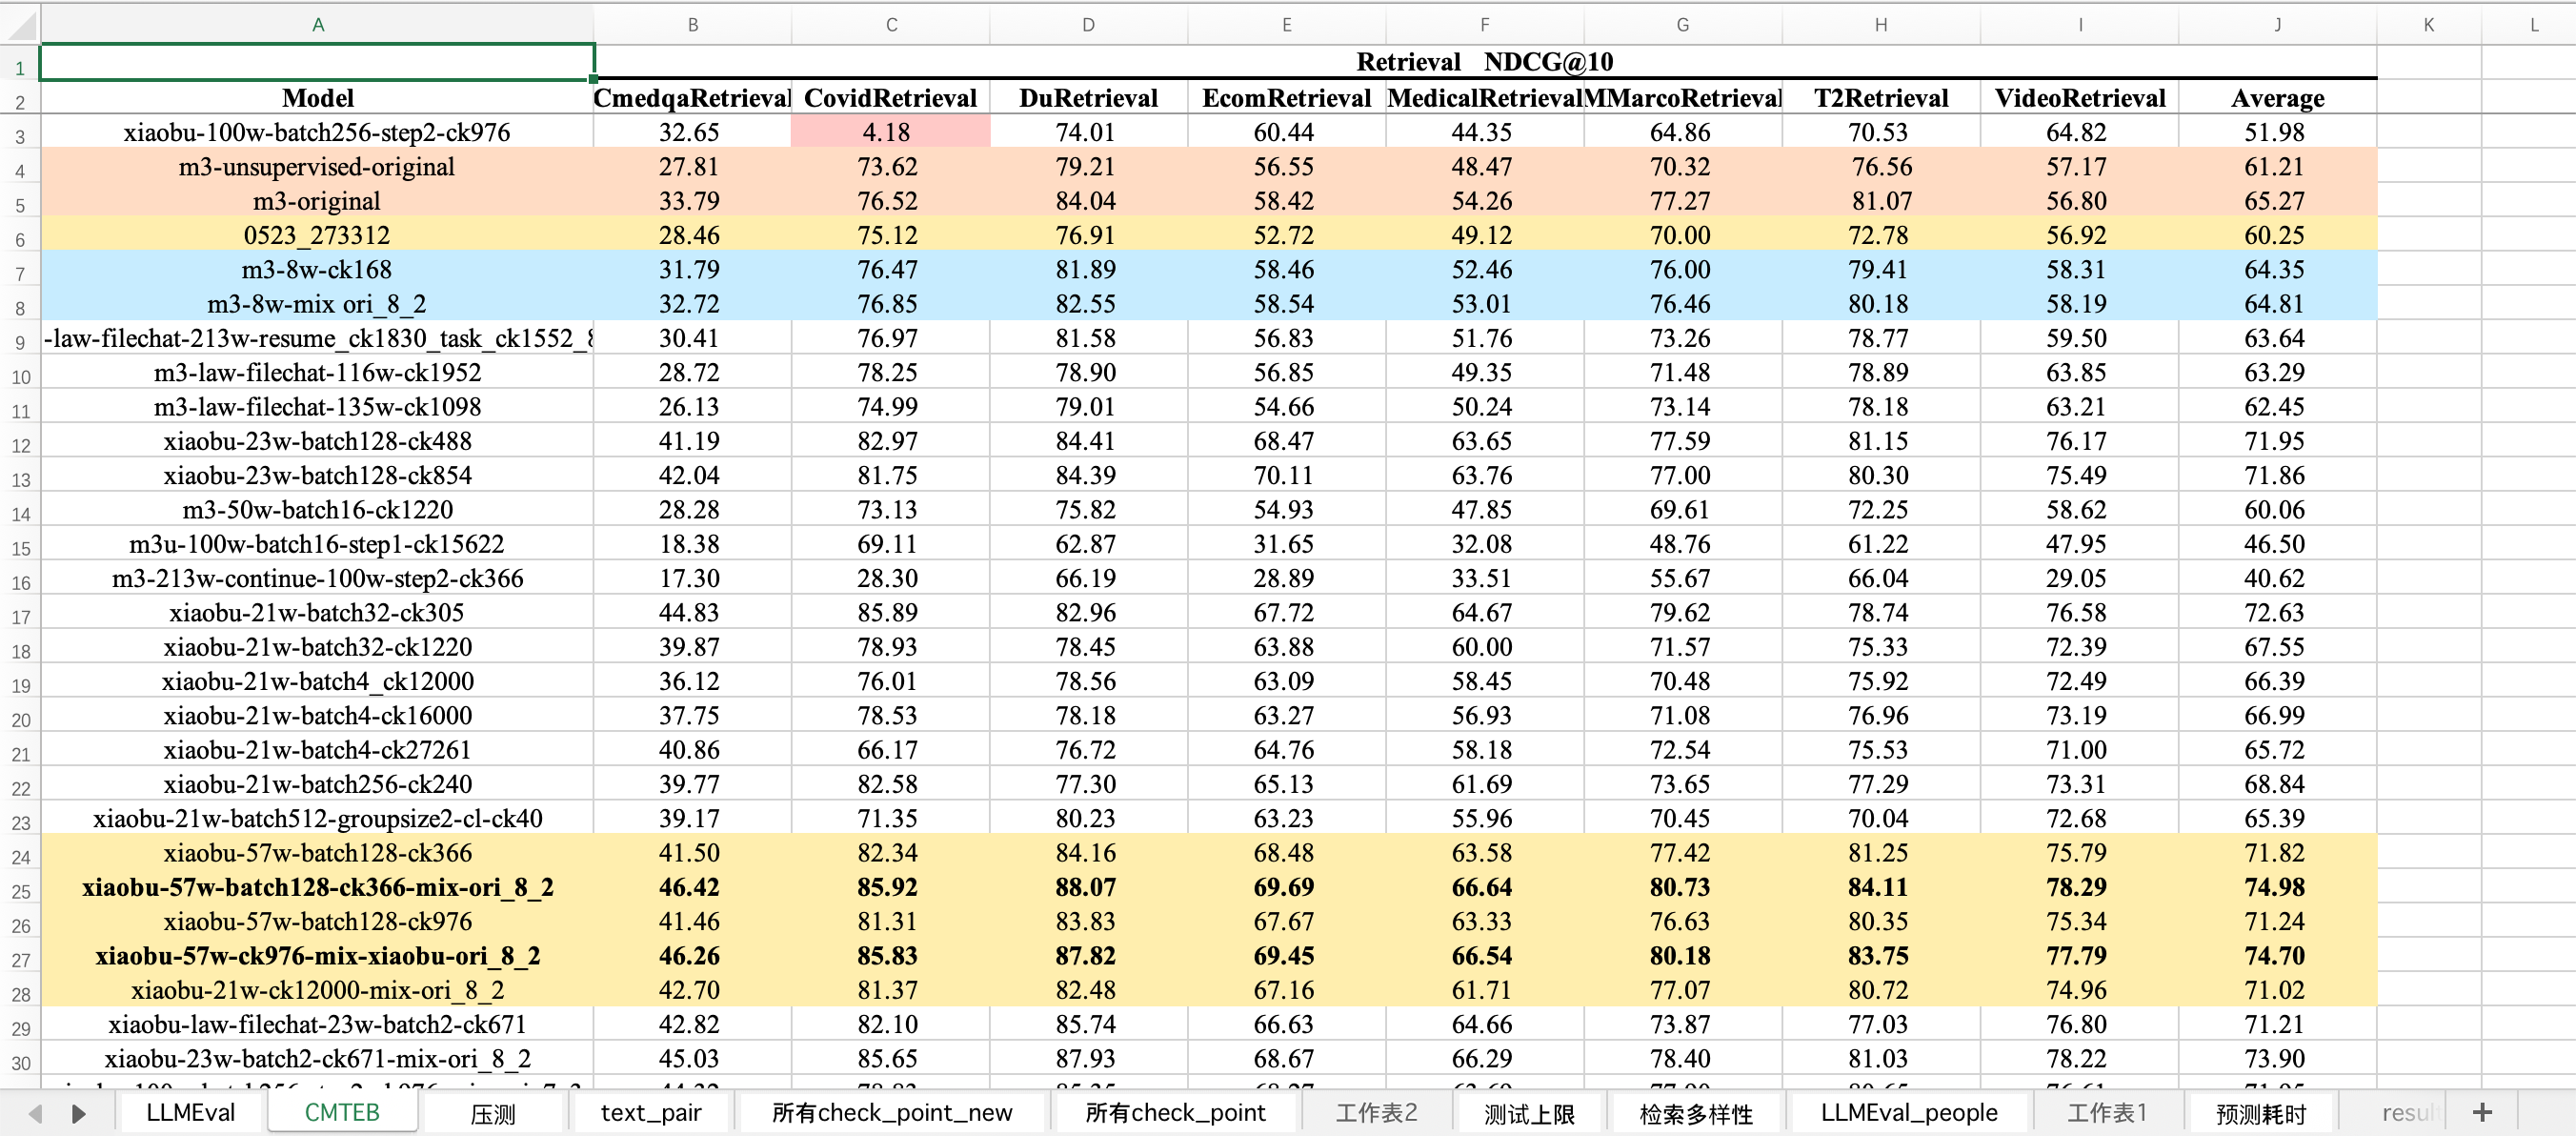
看什么:业务适配后,模型在不同通用检索任务上的表现是否均衡。Average 是图中八个检索任务的均值,此图是检索子任务实验记录。
项目结果与能力沉淀
统一语义底座完成跨行业交付
中国银行约 2 万意图场景,业务意图识别准确率由 73% 提升至 93%;通过模型轻量化与服务优化,服务并发提升约 10 倍。统一底座服务中国银行、交通银行、微众银行、中国联通、广东税务等项目。
指标口径:中国银行约 2 万意图场景统计业务意图识别准确率;服务并发对应模型轻量化与推理服务优化。四张实验图分别展示数据建设、版本选择、难例诊断与通用检索评估。