02 / RAG & EVALUATION
RAG:逐层定位解析、检索与回答的损耗
围绕真实文档问答建设评估集,将问题定位到具体环节,再对照切片、粗排+精排和复杂问答策略。
业务问题
文档问答出错,需要分清解析、切片、检索、精排和生成各环节的损耗。
我的工作
建设 RAG 链路与题型评估,优化结构化、切片、粗排+精排及复杂问答。
主要结果
70% → 90%+RAG 简单题评估集的最终问答准确率先定位相关内容在哪一步丢失
面向政策、法律和企业文档做问答,最终答案错误可能来自多个环节:原文没有正确解析、相关内容被切散、召回未命中、排序未保留正确切片,或模型拿到相关内容后仍回答错误。
我负责 RAG 系统建设、检索链路优化与效果评估,将“回答对不对”拆解为各环节可检查的结果,覆盖文档结构化、切片、Embedding 粗排、Rerank 精排、Query Rewrite 与生成。
用题型评估驱动链路对照
构建有正确切片的评估集
按 6 大类、13 种题型构建 800 道简单题与 80 道复杂题,标注正确切片,覆盖抽取、推理、跨文档、多轮、表格与拒识。
逐层比较检索配置
基于 10 万+篇跨行业文档语料与 10 万级检索训练样本优化模型,比较切片类型、长度、粗排模型、精排模型与候选数量。用 Hit@3 / 5 / 10 检查检索命中,再检查最终答案。
为复杂题增加迭代检索
结合 Query Rewrite 改善查询表达,复杂题引入 ReAct 组织检索与推理;同时评估效果收益与额外推理时延,按题目难度选择链路。
| 评估层 | 检查内容 | 用于区分的问题 |
|---|---|---|
| 文档结构 | 解析结果、切片完整性与正确切片 label | 相关内容是否在可检索语料中 |
| 粗排+精排 | 正确切片的排名、Hit@K、候选数量 | 没有召回,还是排序后被丢弃 |
| 最终问答 | 模型 predict 与答案 label 的正确性对照 | 相关内容正确后,模型能否完成任务 |
两张原图:法律检索与 FileChat 配置实验
两张图保留模型、数据集和配置,便于沿着具体对照讨论技术取舍。法律数据、FileChat 与不同日期的数据批次分别阅读。
实验 1 · 法律数据的粗排+精排与模型对照
完整实验原图 · 点击放大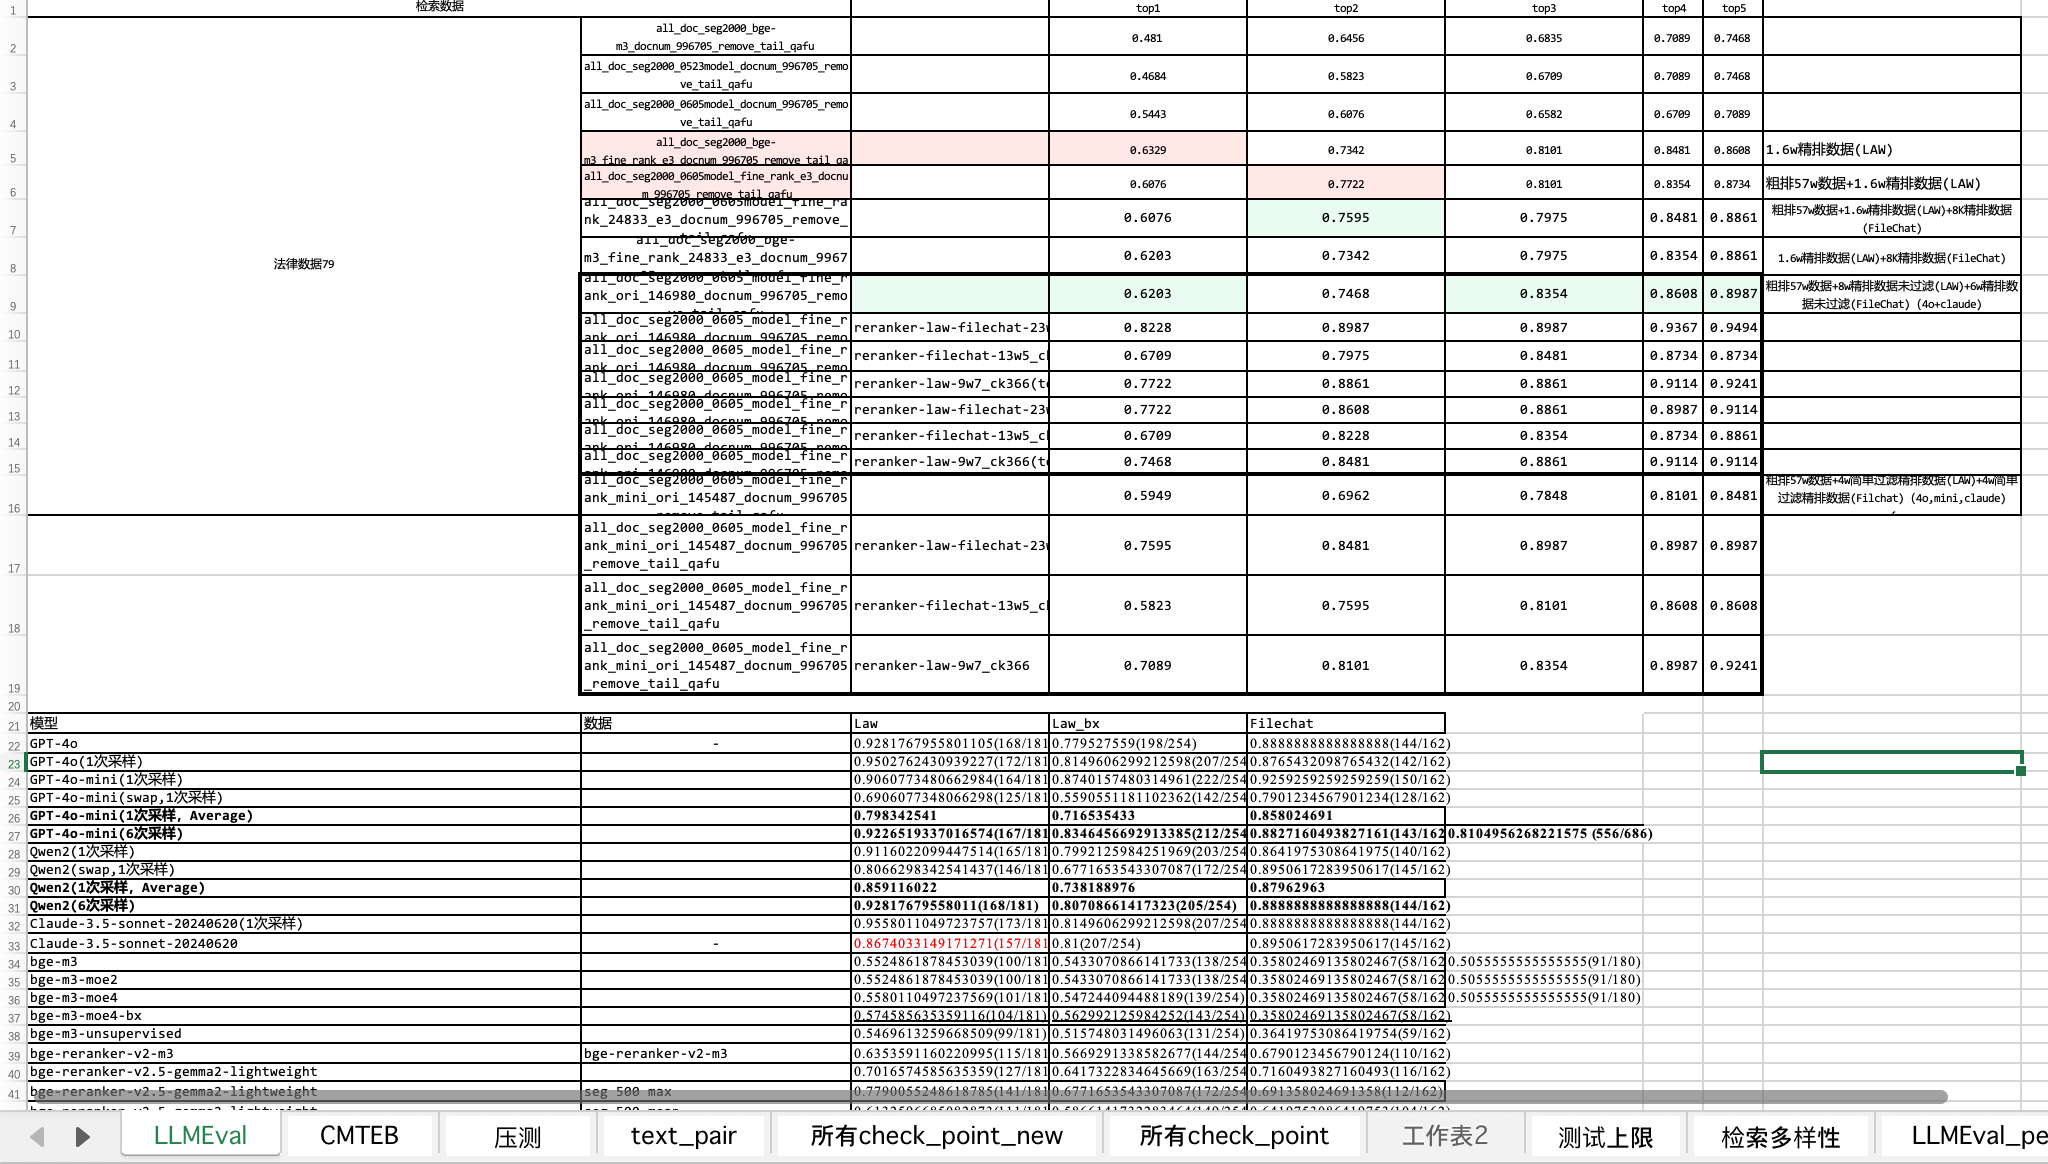
看什么:在法律检索任务上,比较粗排模型与精排训练配置分别带来的变化;下半记录用于核对各评测任务、模型和采样设置。
实验 2 · FileChat 切片、候选数量与命中率
完整实验原图 · 点击放大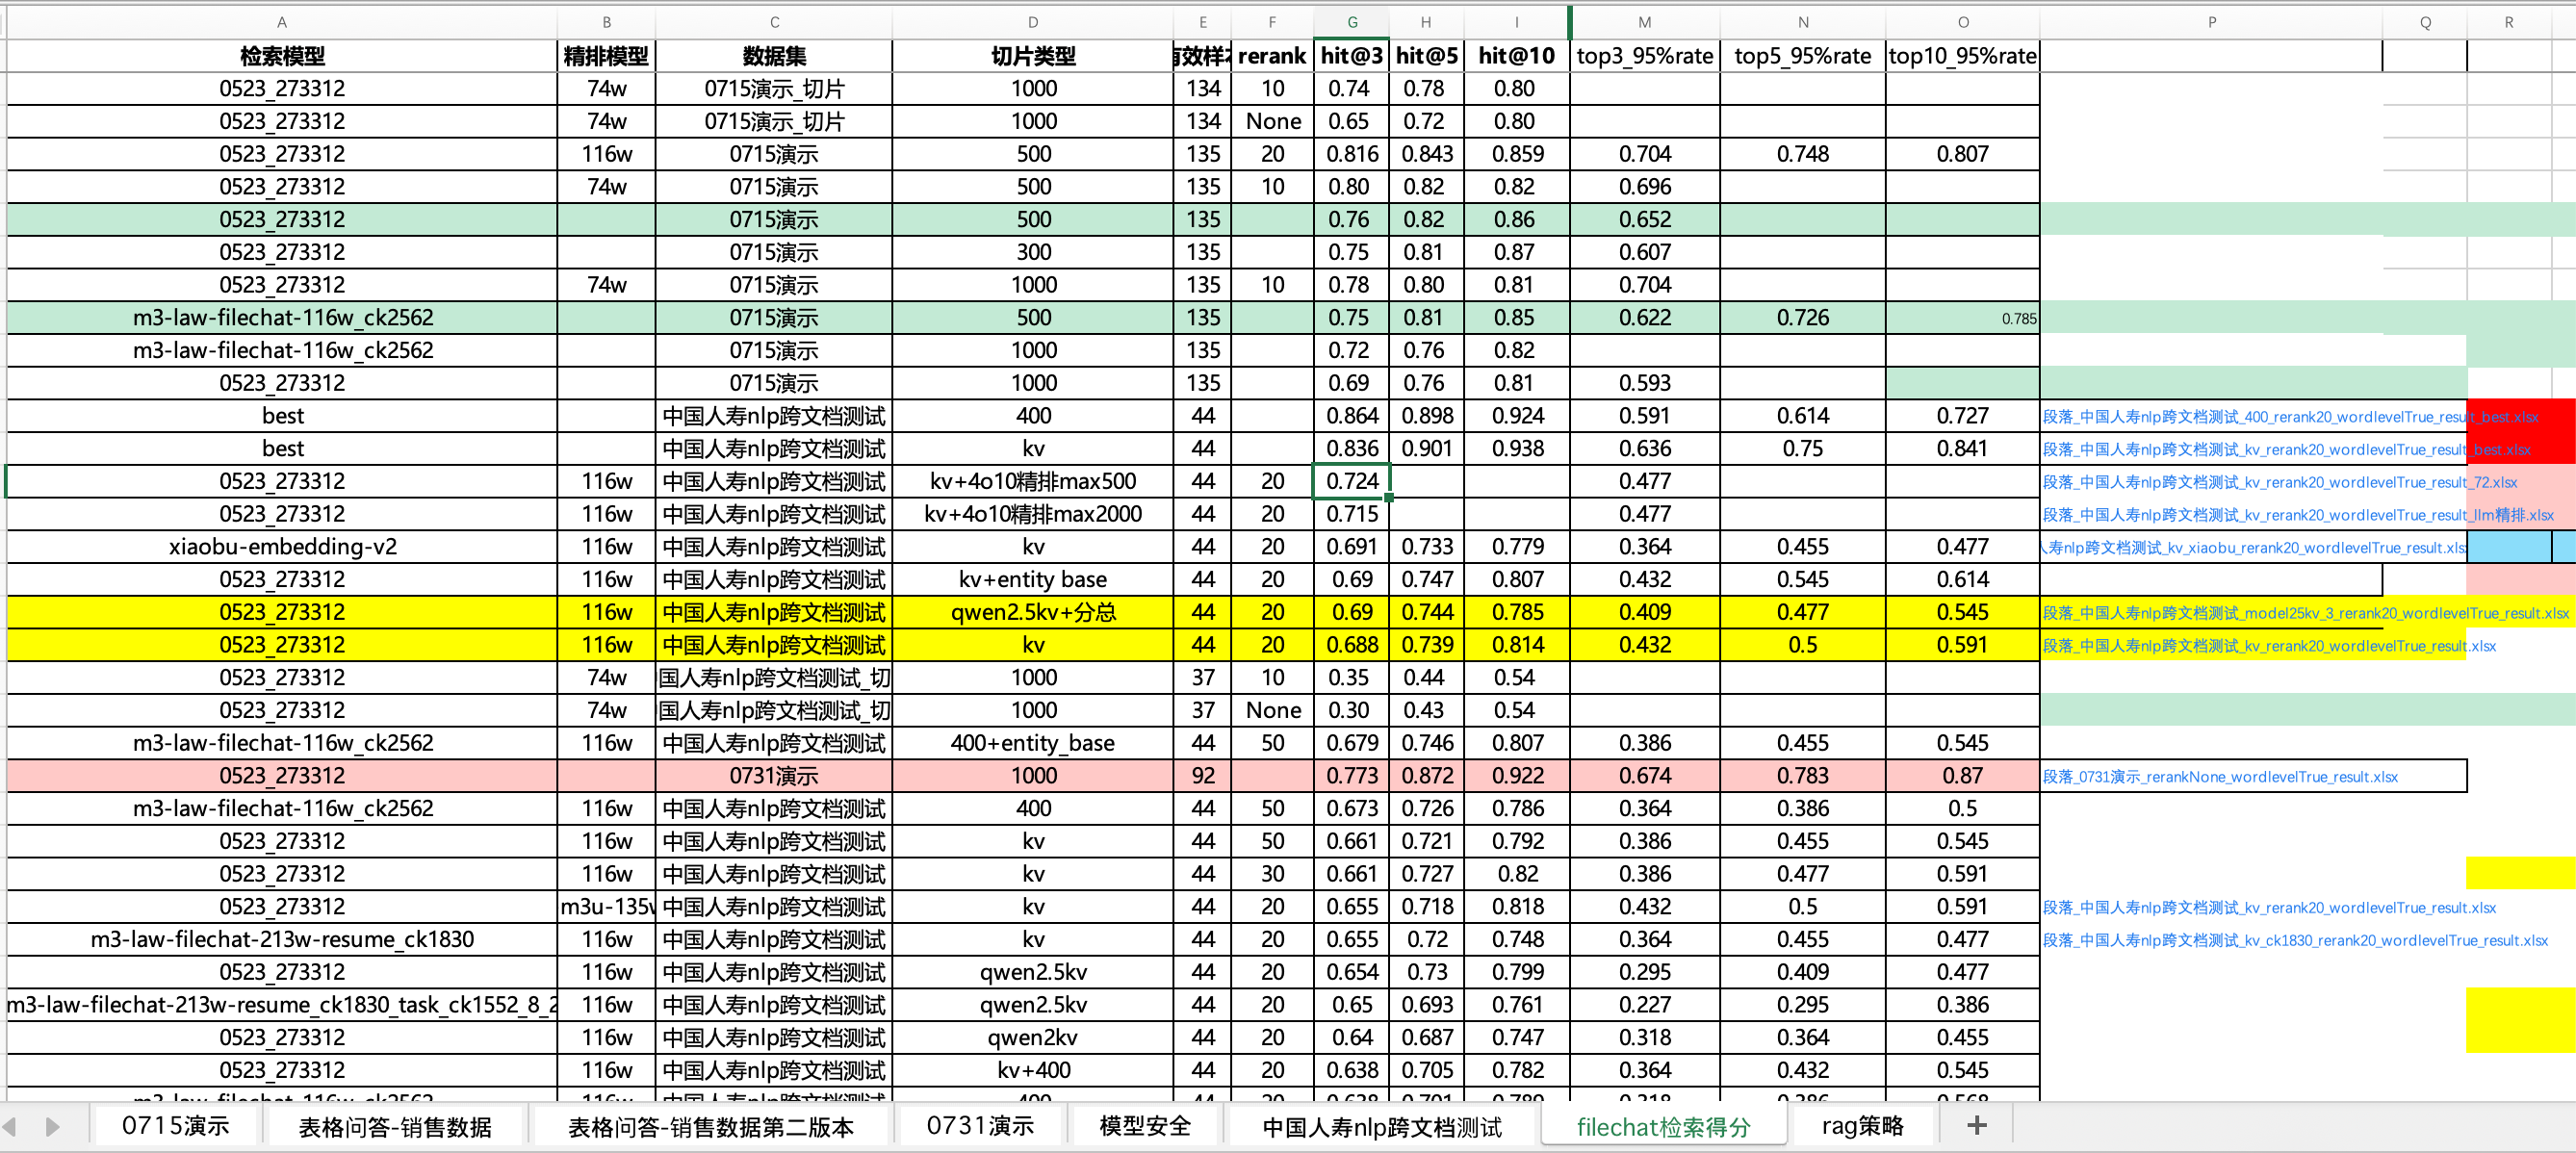
观察:切片策略、模型与精排数量都会影响检索命中。比较时先对齐数据集和有效样本数;134 / 135 / 44 / 37 / 92 等不同样本规模的行不能直接作为统一榜单排名。
结果落实到最终问答与业务交付
从检索优化走到可交付的 RAG 系统
800 道简单题评估集的最终问答准确率由 70% 提升至 90%+;文档检索评估集的 Hit@3 由 70% 提升至 78%,落地东莞税务局(10 万+政策文档)、广州羊城通等项目。题型评估与逐层对照用于持续定位后续问题。
指标口径:最终问答准确率按题目统计;图中 Hit@K 表示正确内容在前 K 条结果中的命中率。法律数据与 FileChat 的配置对照按各自评估批次阅读,分别用于判断检索与模型选型效果。